REFERENCE
開發者參考
認證、API、SDK、Flow Agent 處理節點與參數取值的完整參考。
LLM Completion
呼叫 LLM 產生結構化資料或文字,結果給後面的節點判斷用。
LLM Completion 是用於呼叫大型語言模型並產生結構化資料輸出的 processor。
基本用法
執行 LLM Completion 時,會將設定的 Prompt 發送給指定的 Completion Model,模型會根據提示內容生成回應,並按照 Output Schema 定義的格式輸出結構化資料。適用於文字分析、內容生成、決策輔助、情境判斷、資料提取等需要 AI 智能處理的場景。
配置參數
節點的屬性面板:
Name
顯示在畫布上的名稱,用於在工作流程中識別此 processor。
Description
用於補充此 processor 的用途,提升工作流程的可讀性。
Properties
Completion Model(必填)
選擇要使用的 Completion Model 資源名稱。需要先建立 Completion Model 資源,支援 OpenAI GPT、Claude、Gemini 等模型。
Prompt(必填)
發送給 AI 模型的提示詞,用於描述任務背景與要求。提供資料補充背景和必要的記憶即可,AI 的生成任務目標格式會由 Output Schema 給定。
設定類型
- Literal:直接輸入固定提示內容
- Expression:使用 JavaScript 表達式動態產生提示
- Template:使用模板語法和內建函數組合提示內容
詳細的取值方式說明請參考:Expression 介紹 - 取值方式
Output Schema(必填)
定義 AI 模型輸出資料的 JSON Schema 格式,確保 AI 回應符合預期的結構化格式。最外層一定是一個 object。
MaxTokens(必填)
設定模型提示 + 生成回應的最大 Token 數量,用於控制回應長度和成本。
Temperature
(可選) 模型的溫度值,控制回答的隨機性。數值越高,回答越隨機多樣;數值越低,回答越確定一致。數值範圍限制隨著使用的 completion model 會有所不同,需依照該模型的限制填入。省略時會自動採用模型的預設值。注意:某些模型不支援溫度值參數,請勿在此類模型中設定此欄位。
Effort
推理強度,可設為
low、medium、high、xhigh、max,或auto表示交給模型自行決定。它同時控制思考深度與整體 token 花費,強度越高回應越慢、成本越高。未設定時採用模型預設值。要注意並非每個模型都支援每一個等級,送出一個模型不支援的等級會讓該回合直接失敗。有些模型(特別是速度取向的 Haiku 等級)根本不接受推理強度這個參數,這種情況要設為
disabled,讓系統完全不送出這個欄位。MCP Servers
(可選) 模型可以使用的 toolset 名稱,可從下拉選單選擇。當有設定 toolsets 時,會賦予模型調用這些工具集之下的所有工具。多數情況下,為了使模型更清楚何時該正確的調用何種工具,建議也要於 prompt 處進行向模型相關的調用說明。
Enable OpenAI Web Search
(可選) 是否啟用 OpenAI Web Search 功能。僅限支援 Web Search 的 OpenAI 模型使用。啟用後,模型可搜尋網路資訊來回答問題。(詳細資訊可參考:OpenAI 官方文件)
OpenAI Web Search Context
(可選) 控制從網路檢索多少內容來協助工具產生回應。可選值:'low'(低)、'medium'(中)、'high'(高)。只有在啟用「Enable OpenAI Web Search」設定時,才可以進一步設定此設定值。
Blob IDs
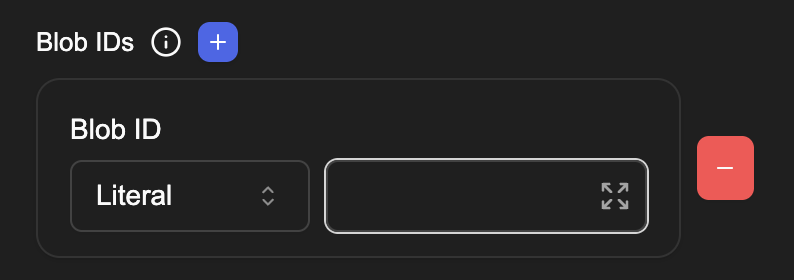
提供給模型分析的圖片或檔案 ID,可點擊 (+) 按鈕後新增多筆 Blob ID資料。僅在使用支援視覺解析功能的 Completion Model 時可用。模型會根據這些內容進行分析並回應。
Semantic Layers
以 JSON 陣列設定要掛給模型的語意模型,每個元素的形狀為:
[
  {
    "name": "<CR name>",
    "allowQuery": true,
    "allowWrite": false,
    "allowedCubes": ["orders", "order_items"]
  }
]
和底下單數形的 Semantic Layer 相比,這個欄位可以一次掛上多個語意模型,讓同一次 LLM 呼叫跨多個資料庫查詢。新的工作流程請使用這個欄位。
Sandbox Blueprint
指定一個 SandboxBlueprint 名稱,為這次 LLM 呼叫建立對應的 Sandbox。設定後系統會先確保 Sandbox 進入 Ready 狀態才送出任務,模型則會取得綁定該 Sandbox 的內建工具(
bash、str_replace_editor),以及在 system prompt 中被探索到的 Skills。留空表示這次呼叫不掛載 Sandbox。
在 Workflow CRD 中的設定
- name: proc-classify
  type: llm-completion
  labels:
    display_name: 判斷詢問類型
  configs:
    - name: completionModel
      value: cm-builtin-balanced
    - name: prompt
      template: |
        使用者說:{{{prevMessage}}}
        判斷這是哪一類詢問。
    - name: outputSchema
      value: |-
        {
          "type": "object",
          "required": ["category"],
          "properties": {
            "category": {
              "type": "string",
              "enum": ["退貨", "物流", "其他"]
            }
          }
        }
    - name: maxTokens
      value: "1024"
    - name: effort
value: lowprompt可以用template撰寫 Handlebars 模板,以三層大括號{{{變數}}}取值可避免內容被 HTML 逸出。Output Schema 中定義的每個 property 都會成為後續 processor 可用的變數。使用範例
客服情境判斷
判斷使用者輸入是否為客服相關問題。使用 Template 設定 Prompt:
你是客服分類助手,需要判斷使用者的問題類型。

使用者訊息:{{{prevMessage}}}

請分析這個訊息並分類。
Output Schema:
{
  "type": "object",
  "properties": {
    "isCustomerSupport": {
      "type": "boolean",
      "description": "是否為客服相關問題"
    },
    "category": {
      "type": "string",
      "description": "問題類別"
    }
  },
  "required": ["isCustomerSupport", "category"]
}
圖片內容分析
使用支援視覺的模型分析使用者上傳的圖片。設定 Blob IDs 使用 Expression:
prevBlobs && prevBlobs.length > 0 ? prevBlobs[0].blobId : nullPrompt:
請分析這張圖片的內容,描述你看到的物體、場景和重要細節。Output Schema:
{
  "type": "object",
  "properties": {
    "description": {
      "type": "string",
      "description": "圖片描述"
    },
    "objects": {
      "type": "array",
      "items": { "type": "string" },
      "description": "識別出的物體清單"
    },
    "scene": {
      "type": "string",
      "description": "場景類型"
    }
  },
  "required": ["description"]
}
對話歷史分析
基於對話歷史分析使用者需求趨勢。使用 Template 取得對話歷史:
請分析以下對話歷史,了解使用者的需求模式:

{{{history 0 -1}}}

目前訊息:{{{prevMessage}}}
Output Schema:
{
  "type": "object",
  "properties": {
    "userIntent": {
      "type": "string",
      "description": "使用者意圖"
    },
    "emotionalState": {
      "type": "string",
      "enum": ["positive", "neutral", "negative"],
      "description": "情緒狀態"
    },
    "topics": {
      "type": "array",
      "items": { "type": "string" },
      "description": "討論主題"
    }
  },
  "required": ["userIntent", "emotionalState"]
}
注意事項
- Output Schema 必須是合法的 JSON Schema,模型的回覆會被要求符合它。
- MaxTokens 是必填,直接影響單次呼叫的成本上限。
Semantic Layers與Blob IDs在面板上是作者可以設定的;早期版本的Semantic Layer Allow Query/Allow Write/Allowed Cubes三個子選項已經不在面板上,由平台端決定。