REFERENCE
開発者リファレンス
認証、API、SDK、Flow Agent のプロセッサ、パラメータ解決のリファレンスです。
LLM Completion
LLM を呼び出して構造化データやテキストを生成し、後続ノードの判断材料にします。
LLM Completion は大規模言語モデルを呼び出し、構造化されたデータを出力するプロセッサーです。
基本的な使い方
LLM Completion は設定された Prompt を指定の Completion Model に送ります。モデルが応答を生成し、出力は Output Schema で定義された形に整えられます。テキスト分析、コンテンツ生成、判断の補助、状況の分類、データ抽出など、モデルによる処理が必要な場面で使います。
設定項目
ノードのプロパティパネルです。
Name
キャンバス上に表示される名前です。ワークフロー内でこのプロセッサーを識別するために使います。
Description
このプロセッサーの用途を補足し、ワークフローの読みやすさを高めます。
Properties
Completion Model(必須)
使用する Completion Model リソースの名前です。あらかじめリソースを作成しておく必要があります。OpenAI GPT、Claude、Gemini などに対応しています。
Prompt(必須)
モデルへ送る指示で、タスクの背景と要件を記述します。文脈と必要な記憶を与えれば十分で、出力の形は Prompt ではなく Output Schema が決めます。
値の種類
- Literal: 指示をそのまま入力します
- Expression: JavaScript の式で指示を組み立てます
- Template: テンプレート構文と組み込み関数で指示を構成します
値の取得方法はExpression の概要 — 値の取得を参照してください。
Output Schema(必須)
モデルの出力を定義する JSON Schema です。応答が期待どおりの構造で返るようにします。最も外側は必ずオブジェクトです。
MaxTokens(必須)
プロンプトと応答を合わせた token の上限です。応答の長さとコストの両方を制御します。
Temperature
(任意) モデルの温度で、回答のばらつきを制御します。高いほど多様に、低いほど一貫します。指定できる範囲は completion model によって異なるため、そのモデルの制限に従ってください。省略するとモデルの既定値が使われます。温度に対応しないモデルもあるため、その場合はこの項目を設定しないでください。
Effort
推論の強度です。
low、medium、high、xhigh、max、またはモデルに委ねるautoを指定できます。思考の深さと token の総消費量の両方を制御するため、高いほど遅く高価になります。未設定の場合はモデルの既定値が使われます。すべてのモデルがすべての段階に対応しているわけではなく、対応していない段階を送るとそのターンは失敗します。速度重視の Haiku 系など、推論強度のパラメータ自体を受け付けないモデルもあります。その場合は
disabledを設定し、この項目を送らないようにします。MCP Servers
(任意) モデルが利用できる toolset の名前で、ドロップダウンから選びます。toolset を設定すると、その配下のすべてのツールがモデルに与えられます。多くの場合、どのツールをいつ呼ぶべきかを prompt にも書いておくと、モデルが適切に選べます。
エディター上の表示は MCP Servers で、Workflow CRD を書くときの config キーは
toolsetsです。Enable OpenAI Web Search
(任意) OpenAI Web Search を有効にするかどうかです。対応する OpenAI のモデルでのみ使えます。有効にすると、モデルがウェブを検索して回答できます。(OpenAI の公式ドキュメントを参照してください。)
OpenAI Web Search Context
(任意) 回答の生成を助けるためにウェブからどれだけ内容を取得するかです。'low'、'medium'、'high' から選べます。Enable OpenAI Web Search が有効なときにのみ設定できます。
Blob IDs
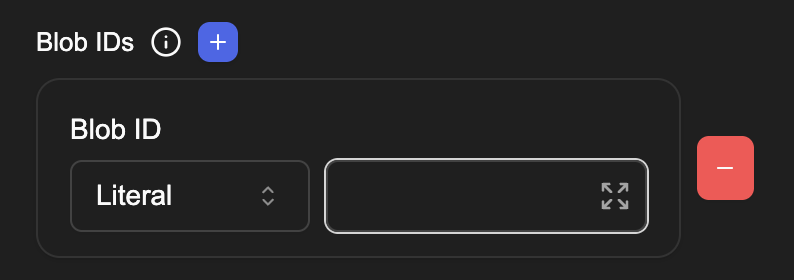
モデルに解析させる画像やファイルの ID です。(+) をクリックして複数追加できます。視覚に対応した Completion Model でのみ利用できます。モデルはこの内容を解析して回答します。
Semantic Layers
モデルに掛ける意味モデルを JSON 配列で設定します。各要素の形は次のとおりです。
[
  {
    "name": "<CR name>",
    "allowQuery": true,
    "allowWrite": false,
    "allowedCubes": ["orders", "order_items"]
  }
]
下にある単数形の Semantic Layer と比べ、この項目は複数の意味モデルを同時に掛けられ、一度の LLM 呼び出しで複数のデータベースを横断して検索できます。新しいワークフローではこちらを使ってください。
Sandbox Blueprint
この LLM 呼び出しのために Sandbox を用意する SandboxBlueprint の名前です。設定すると、システムは Sandbox が Ready になってからタスクを送り、モデルはその Sandbox に紐づく組み込みツール(
bash、str_replace_editor)と、system prompt 内で見つかった Skills を利用できます。空欄にすると、この呼び出しでは Sandbox を使いません。
Workflow CRD での設定
- name: proc-classify
  type: llm-completion
  labels:
    display_name: 問い合わせの分類
  configs:
    - name: completionModel
      value: cm-builtin-balanced
    - name: prompt
      template: |
        ユーザーの発言: {{{prevMessage}}}
        これがどの種類の問い合わせかを判断してください。
    - name: outputSchema
      value: |-
        {
          "type": "object",
          "required": ["category"],
          "properties": {
            "category": {
              "type": "string",
              "enum": ["返品", "配送", "その他"]
            }
          }
        }
    - name: maxTokens
      value: "1024"
    - name: effort
value: lowpromptはtemplateで Handlebars のテンプレートとして書けます。三重の波括弧{{{変数}}}で値を読むと HTML エスケープを避けられます。Output Schema で定義した各プロパティは、後続のプロセッサーで使える変数になります。使用例
サポート問い合わせの分類
判斷使用者輸入是否為客服相關問題。使用 Template 設定 Prompt:
你是客服分類助手,需要判斷使用者的問題類型。

使用者訊息:{{{prevMessage}}}

請分析這個訊息並分類。
Output Schema:
{
  "type": "object",
  "properties": {
    "isCustomerSupport": {
      "type": "boolean",
      "description": "是否為客服相關問題"
    },
    "category": {
      "type": "string",
      "description": "問題類別"
    }
  },
  "required": ["isCustomerSupport", "category"]
}
画像の内容分析
使用支援視覺的模型分析使用者上傳的圖片。設定 Blob IDs 使用 Expression:
prevBlobs && prevBlobs.length > 0 ? prevBlobs[0].blobId : nullPrompt:
請分析這張圖片的內容,描述你看到的物體、場景和重要細節。Output Schema:
{
  "type": "object",
  "properties": {
    "description": {
      "type": "string",
      "description": "圖片描述"
    },
    "objects": {
      "type": "array",
      "items": { "type": "string" },
      "description": "識別出的物體清單"
    },
    "scene": {
      "type": "string",
      "description": "場景類型"
    }
  },
  "required": ["description"]
}
会話履歴の分析
基於對話歷史分析使用者需求趨勢。使用 Template 取得對話歷史:
請分析以下對話歷史,了解使用者的需求模式:

{{{history 0 -1}}}

目前訊息:{{{prevMessage}}}
Output Schema:
{
  "type": "object",
  "properties": {
    "userIntent": {
      "type": "string",
      "description": "使用者意圖"
    },
    "emotionalState": {
      "type": "string",
      "enum": ["positive", "neutral", "negative"],
      "description": "情緒狀態"
    },
    "topics": {
      "type": "array",
      "items": { "type": "string" },
      "description": "討論主題"
    }
  },
  "required": ["userIntent", "emotionalState"]
}
注意事項
- Output Schema は妥当な JSON Schema である必要があり、モデルの返答はそれに従うよう制約されます。
- MaxTokens は必須で、1 回の呼び出しのコスト上限になります。
Semantic LayersとBlob IDsはパネル上で作成者が設定できる項目です。以前のSemantic Layer Allow Query/Allow Write/Allowed Cubesはパネルから外れ、プラットフォーム側で決まります。